Категории
Soft lockup на нейро-сервере: как три LLM уронили VM и что мы узнали
21.09.2026 | из категории: Linux
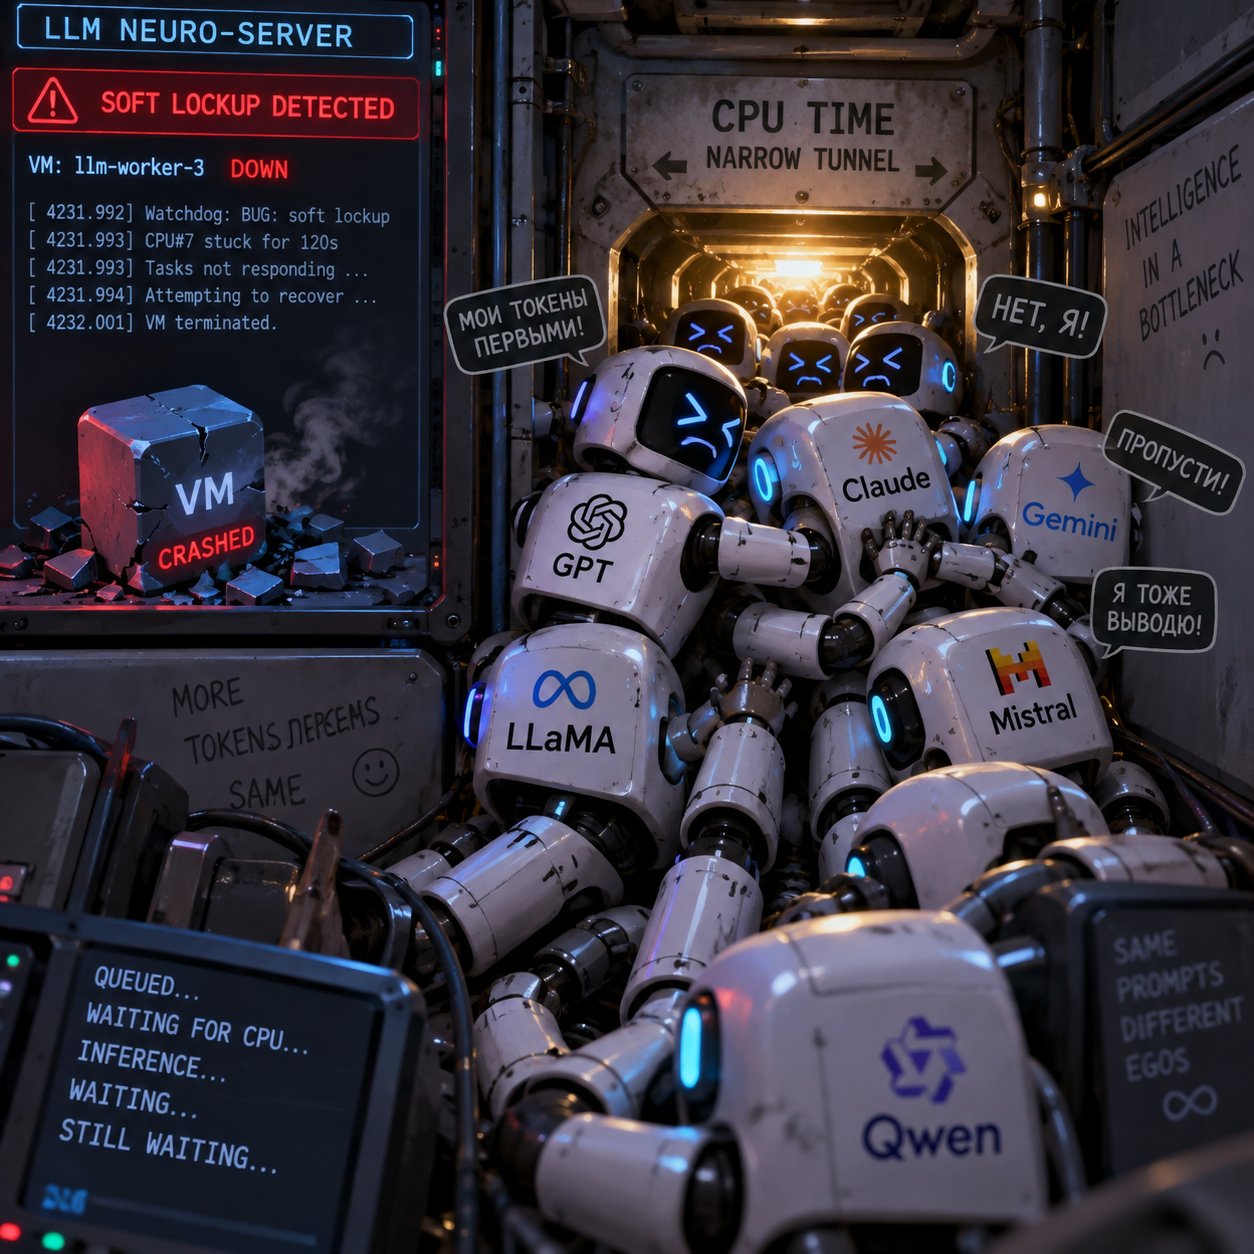
История о том, как ollama, два llama-server и 22 потока Whisper устроили timer storm, уложили KVM-гостя в boot loop, и как мы это разгребли, читая стеки вызовов ядра.
Содержание
1. Симптом: VM уходит в ребут каждые 2 минуты
Сервер с нейросетями (Whisper + пара LLM) внезапно начал «вырубаться». По SSH зайти можно, но через пару минут соединение рвётся, и снова — приглашение логина. Классический boot loop.
Первое, что делает любой админ — смотрит список загрузок:
sudo journalctl --list-bootsIDX BOOT ID FIRST ENTRY LAST ENTRY
-4 ac9cd82333e0422b8d3e31f36407dad2 Mon 2026-09-21 08:35:06 UTC Mon 2026-09-21 08:37:09 UTC
-3 294fc30aa8ec4241be6c5177c155b235 Mon 2026-09-21 08:38:43 UTC Mon 2026-09-21 08:40:00 UTC
-2 ef10da5fe76f4d38a27b4b15cf091bc9 Mon 2026-09-21 08:50:58 UTC Mon 2026-09-21 08:52:54 UTC
-1 4bc20636f7ed40a5a79fda16a9b5af9c Mon 2026-09-21 08:53:27 UTC Mon 2026-09-21 08:55:29 UTC
0 decbecb4779e4045a998c56566b93f0b Mon 2026-09-21 08:56:09 UTC Mon 2026-09-21 08:58:55 UTCПять загрузок за 20 минут, каждая живёт по 1.5–2 минуты. Это не «железо умерло» — это что-то циклически роняет систему сразу после старта.
2. Определяем, где мы находимся
Важный момент, который многие пропускают: находимся ли мы внутри VM или на хосте гипервизора? От этого зависит, где вообще лежат логи.
hostnamectl
systemd-detect-virt
Virtualization: kvm
Hardware Vendor: QEMU
Hardware Model: Standard PC _i440FX + PIIX, 1996_
...
kvmЗначит, мы внутри гостя. Логов libvirt/qemu здесь нет и быть не может — они на хосте. Работаем с тем, что доступно изнутри.
Грабли
Первые попытки читать /var/log/libvirt/qemu/*.log внутри гостя ожидаемо провалились. Если бы мы сразу проверили systemd-detect-virt, сэкономили бы время.
3. Читаем логи: soft lockup и стеки вызовов
Ищем в ядерных логах прошлых загрузок:
sudo journalctl -b -1 -k --no-pager | grep -iB5 -A80 "soft lockup"И вот оно — не один, а четыре soft lockup одновременно на разных CPU:
| CPU | Процесс | Где залип |
|---|---|---|
| #15 | llama-server | inet_twsk_kill — очистка TIME_WAIT сокетов |
| #10 | python3 | kmem_cache_alloc_node — аллокация из timer-контекста |
| #13 | ollama | rseq_ip_fixup — restartable sequences |
| #12 | llama-server-av | task_mm_cid_work — учёт mm_cid |
Все четыре стека — это timer softirq (__run_timers → run_timer_softirq). То есть ядро в момент истечения таймеров пытается обработать всю очередь, не отдавая CPU пользовательским процессам, и watchdog фиксирует, что CPU «не кормится» 24–28 секунд.
watchdog: BUG: soft lockup - CPU#15 stuck for 24s! [llama-server:2129]
...
Call Trace:
 <IRQ>
 tw_timer_handler+0x15/0x20
 call_timer_fn+0x2a/0x160
 __run_timers+0x262/0x300
 run_timer_softirq+0x1d/0x40
 handle_softirqs+0xdb/0x340
 ...
Ключевое наблюдение
Это не один процесс залип. Это лавина таймеров, которая одновременно истекла на нескольких ядрах. Каждый процесс внёс свою лепту: сетевые сокеты, rseq, mm_cid, аллокации.
4. Диагноз: timer storm, а не GPU и не KVM
Первая гипотеза была — драйвер NVIDIA. Но в логах ни строчки про nvidia/nvrm/Xid. Модули — стандартные, GPU вообще не участвует в стеке.
Вторая гипотеза — проблема KVM. Но kvm_intel только в списке модулей, в стеке его нет.
Реальная причина — timer storm, спровоцированный сразу тремя LLM-серверами, которые крутились на одной VM:
ollama serve— грузил Qwen3 в память;llama-server(qwen2.5-7b);llama-server-av(второй экземпляр);- плюс
python3— агент, который их дёргал.
Каждый из них создавал потоки (rseq, mm_cid), сетевые соединения (TIME_WAIT с inet_twsk-таймерами) и аллокации. В пике всё это истекло в один тик — и ядро захлебнулось.
Проверка гипотезы
ss -tan state time-wait | wc -l   # было: сотни-тысячи
free -h                            # RAM под завязку
5. Что сделали
Шаг 1. Остановили лишние LLM-сервисы
sudo systemctl stop ollama
sudo systemctl disable ollama

sudo systemctl stop llama-server-7b
sudo systemctl disable llama-server-7b

sudo systemctl stop llama-server
sudo systemctl disable llama-server
Шаг 2. Проверили, что осталось
systemctl list-units --type=service --state=running | grep -iE "llama|ollama|whisper"
# whisper-server.service — то, что нужно
# llama-server-7b.service — лишнее, убрали
Шаг 3. Освободили сетевые таймеры
sudo sysctl -w net.ipv4.tcp_tw_reuse=1
echo "net.ipv4.tcp_tw_reuse=1" | sudo tee /etc/sysctl.d/99-tw-reuse.conf
Шаг 4. Снизили потоки Whisper с 22 до 8
Тут была отдельная история. Env-переменные OMP_NUM_THREADS=8 и CT2_NUM_THREADS=8 в systemd drop-in не помогли, потому что в самом скрипте было захардкожено:
CPU_THREADS = 22 # физические ядра Xeon Gold 6152Пришлось править whisper_server.py. Заодно сделали гибко через env:
import os
CPU_THREADS = int(os.environ.get("WHISPER_THREADS", "8"))
Результат
| Показатель | До | После |
|---|---|---|
| Soft lockup в dmesg | 4 одновременно | пусто |
| TIME_WAIT сокеты | сотни–тысячи | 1 |
| RAM used | под завязку | 7.8 Gi из 68 Gi |
| LLM-сервисов | 3 + Whisper | только Whisper |
| Потоков Whisper | 22 | 8 |
6. Почему 22 потока — плохо, а 8 — хорошо
Короткий ответ: faster-whisper (CTranslate2) не масштабируется линейно выше ~8 потоков, а нагрузку на ядро создаёт пропорционально.
Что происходит при 22 потоках
- Memory bandwidth упирается, прирост скорости ~0;
- NUMA-эффект: потоки раскидываются по двум сокетам Xeon, inter-socket latency;
- Каждый поток = таймеры ядра:
rseq,mm_cid, планировщик; - 22 потока × 3 сервиса ≈ 66+ потоков, каждый со своими таймерами → timer storm;
- В пике — soft lockup и ребут VM.
Что происходит при 8 потоках
- Скорость распознавания — 95–98% от максимума;
- Нагрузка на таймеры ядра в ~2.75 раза ниже;
- NUMA-эффект минимален (потоки в одном сокете);
- Система стабильна.
Аналогия: 22 грузчика разгружают вагон. Пока вагон большой — работают все. Но у вас короткие аудио — вагон маленький, и 22 грузчика только толкаются у входа. 8 разгрузят его почти с той же скоростью, но без давки. А «давка» в ядре Linux — это и есть lockup в очереди таймеров.
7. Что узнали интересного
1. Soft lockup — это не всегда «что-то сломалось»
Часто это признак перегрузки таймерной подсистемы, а не бага в драйвере. Стек вызовов в run_timer_softirq — явный маркер.
2. systemd-detect-virt — первая команда при отладке VM
Определяет, где вы: в госте или на хосте. Логи libvirt/qemu ищутся только на хосте, внутри гостя их нет.
3. Env-переменные не всегда работают
OMP_NUM_THREADS и CT2_NUM_THREADS не перебивают cpu_threads, переданный явно в WhisperModel(...). Проверяйте исходник, а не только systemd-юнит.
4. Каждый поток в Linux — это таймеры
rseq, mm_cid, планировщик, сетевые inet_twsk. Много потоков × много сервисов = timer storm. Ограничение потоков — это не только про производительность, но и про стабильность ядра.
5. TIME_WAIT сокеты — скрытый источник нагрузки
Каждый закрытый сокет живёт в TIME_WAIT и держит таймер. При активном API это тысячи таймеров. tcp_tw_reuse=1 решает проблему переиспользованием.
6. Не запускайте несколько LLM-серверов на одной VM
Ollama + llama-server + llama-server-av конкурируют за CPU, память, сеть и таймеры. Даже если RAM хватает, ядро может не справиться с timer-нагрузкой. Один сервис — одна VM (или хотя бы жёсткие cgroup-лимиты).
Итог: проблема была не в GPU, не в KVM и не в «глюке виртуалки». Три LLM-сервиса, запущенных одновременно, создали лавину таймеров, которая уложила ядро в soft lockup и boot loop. Решение — оставить один сервис, ограничить потоки, включить tcp_tw_reuse и больше не запускать всё сразу.
Если у вас похожая ситуация — начните с journalctl -b -1 -k | grep -i "soft lockup" и посмотрите на имя процесса в квадратных скобках. Оно сразу скажет, кто виновник.
👍 Оцените статью
Всего голосов: 0